
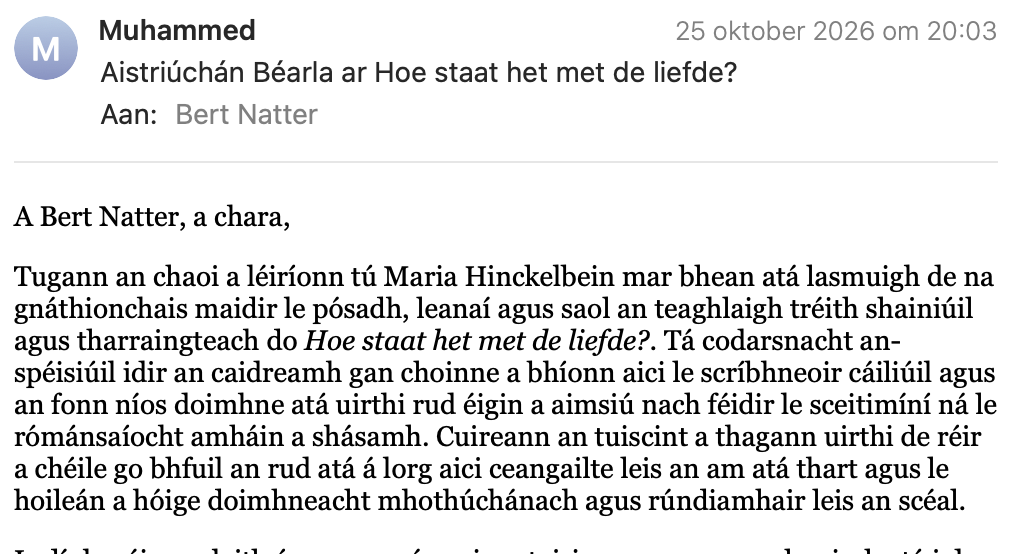
Mijn tactiek om pogingen tot oplichting te belonen met mails in andere talen (zie mijn eerdere berichtgeving) heeft zijn vruchten afgeworpen: ik kreeg van de week spontaan een in het Iers (dat denk ik tenminste) gestelde mail van ‘Ajax Muhammed’ (onthoud die naam, want je zult hem nooit meer horen) waarin hij probeert (ik weet het niet zeker, want ik lees geen Iers) me een poot uit te draaien aan de hand van mijn roman Hoe staat het met de liefde?
Dit soort mails komen overigens altijd binnen op mijn openbare mailadres, dat te vinden is op deze website. Normale spam komt (in grotere hoeveelheden) binnen via mijn privémailadres. Ooit bedacht ik dat het slim was om mijn privémail niet op mijn website te zetten, uit angst voor spam. Dankzij de hacks van onder meer Odido komt de generieke spam nu juist op mijn privémail binnen. Op mijn openbare mailadres ontvang ik als het om spam gaat vrijwel uitsluitend rechtstreeks aan mij gerichte troep.
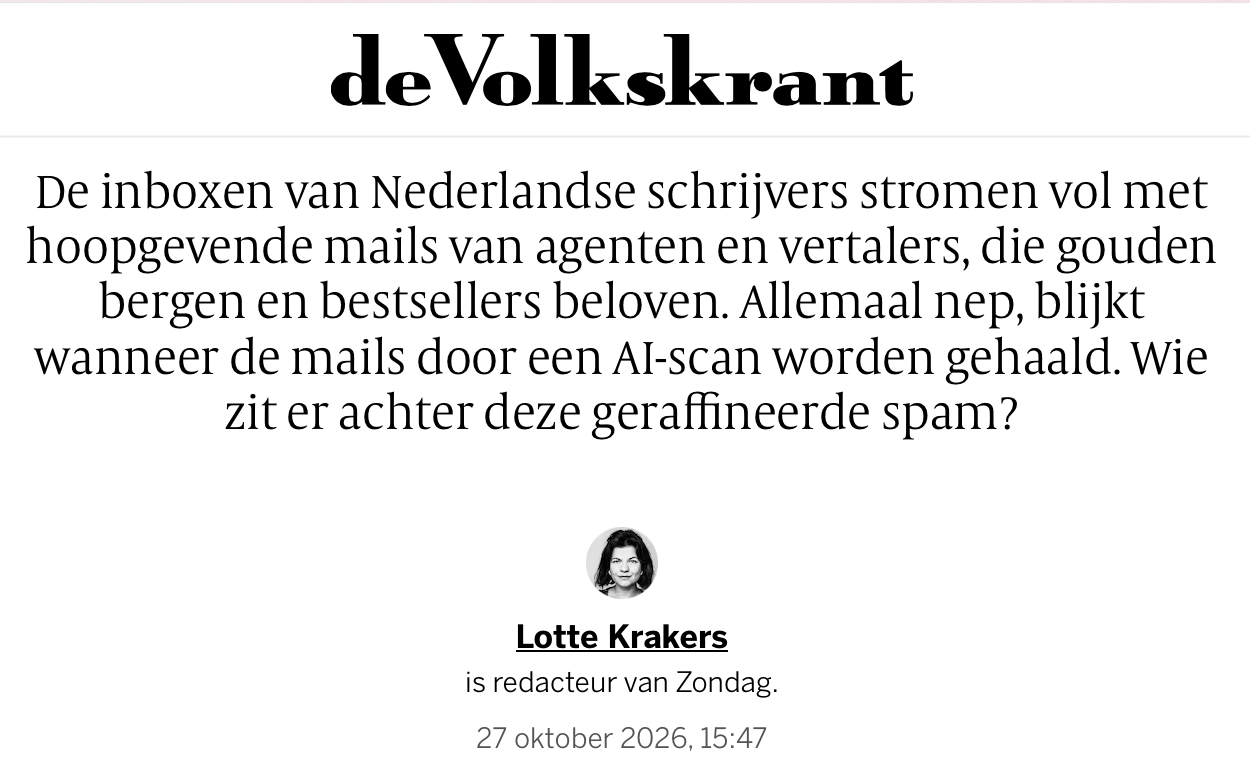
Vandaag besteedt de Volkskrant in een artikel van Lotte Krakers aandacht aan de scams die op schrijvers zijn gericht. Natuurlijk richten de oplichters hun pijlen op de ijdelheid van schrijvers (‘er is iemand die mijn roman onder de aandacht wil brengen van Franse, Duitse en Engelse uitgevers!’), maar dat is niet de enige reden waarom ik die mails toch elke keer bekijk, zeker als ze kort zijn. Ik wil namelijk niet dat iemand die een serieuze vraag stelt over een van mijn boeken wordt behandeld als een malafide chatbot.
Naar aanleiding van Leven met Lidewij zoeken mensen met een kind met een beperking contact met me, om maar iets te noemen. Ook zijn er kleine leesclubs die informeren of ik langs wil komen en onlangs zelfs een serieuze mail van een Amerikaanse investeerder die informeerde naar de filmrechten van een van mijn boeken. Ik vind dat die mensen een antwoord verdienen — en het meest kwalijke van al die nepmails is dan ook dat echte mensen met wantrouwen tegemoet worden getreden. Het kost tijd om elke keer te bepalen of je flauwekul ontvangt of niet. Het schijnt dat AI mensen tijdwinst oplevert; mij niet.
En nu we toch over de geneugten van door AI-gegenereerde teksten spreken, ik schreef een tijdje geleden over een opmerkelijke zin in een door een chatbot gegenereerde column in de stijl van Peter Middendorp:
De overdekte passage is moderner geworden, de mensen lopen nog altijd even gestaag door de motregen.
Ik citeerde in dat stuk een uitspraak van Sam Altman (topman van OpenAI, het bedrijf achter ChatGPT) waarvan ik de leugenachtigheid op dat moment nog niet doorzag (mind you, dit is uit een verklaring van Altman voor het Britse House of Lords in 2023):
Because copyright today covers virtually every sort of human expression – including blogposts, photographs, forum posts, scraps of software code, and government documents – it would be impossible to train today’s leading AI models without using copyrighted materials.
Deze redenering an sich heb ik al behandeld, nu gaat het om het woord ‘to train’ in combinatie met ‘models’. Als ik dit lees, verwacht ik dat een model, dus een systeem dat ergens onder ligt, tijdelijk wordt getraind met materiaal waarop auteursrecht rust. De twee specifieke woorden die Altman gebruikt, wekken de indruk dat dit om voorbereidende, fundamentele werkzaamheden gaat. Eenmaal getraind kan het model aan de slag, toch? Het wordt als een elementair leerproces gepresenteerd.
Maar volgens mij is dat niet hoe het werkt. Pas als iemand de opdracht geeft: schrijf eens een column a la Peter Middendorp, begint het systeem zich te trainen op diens stijl. Het systeem raadpleegt een paar honderd columns en wat interviews en komt dan, na een duizelingwekkend aantal berekeningen, met een column die inderdaad lijkt op een echte column (vroeger werd over de methode van uitgevers die veel boeken publiceerden in de hoop op een bestseller gezegd: ze gooien een bord spaghetti tegen de muur en kijken wat er blijft hangen; ChatGPT gooit een container spaghetti tegen de muur).
Het schenden van het auteursrecht heeft dus niet alleen plaatsgevonden bij het ontwikkelen van het model, het vindt voortdurend plaats. Het is niet zo dat een chatbot die één keer een column op de wijze van Middendorp heeft gefabriceerd er twee dagen later weer eentje uit zijn mouw schudt. Dan begint het systeem gewoon opnieuw alles van Middendorp te scannen.
Daarbij lijkt het me sterk dat de chatbot nadat deze geprompt is keurig naar de site van de Volkskrant gaat om daar als een betalende abonnee met de zoekfunctie in het archief te zoeken. Nee, al die AI-systemen grazen voortdurend het internet af, stelen alles wat ze tegenkomen en bewaren dat zelf. Deze systemen — dit is allemaal mijn lekenmening — moeten gigantische hoeveelheden tekst bewaren en op commando kunnen doorzoeken om zich te trainen op het moment dat iemand vraagt om een column in de stijl van een willekeurige auteur in een willekeurige taal.
De termen die Sam Altman gebruikte, waarin hij sprak over het trainen van een model, zijn misleidend. Ik denk dat iedere oningewijde bij het het ‘trainen’ van ‘een model’ denkt aan een voorbereidende activiteit en niet aan een voortdurend proces van auteursrechtenschendingen. Grappig genoeg komt de mislukte quasi-column in de stijl van Middendorp uiteindelijk ook weer in het systeem.
Als je het je zo voorstelt, kun je begrijpen waarom de LLM’s zo bang zijn dat hun systemen worden uitgehold, doordat ze namelijk continu bezig zijn tekst te stelen en dus steeds meer van hun eigen taaluitwerpselen tegenkomen. En poep eten is niet lekker.
Daarom lazen we een tijdje geleden al in de krant dat AI-bedrijven oude papieren boeken opkopen en scannen, allemaal om maar niet door hun eigen rommel geïnfecteerd bloed in het hart van hun systeem te pompen: teksten die ooit zonder AI werden geschreven. Die actie kreeg veel aandacht, omdat de gescande boeken, soms unieke exemplaren, vervolgens werden vernietigd. Maar deze manier van werken laat vooral zien hoe onbehouwen AI-bedrijven teksten van het internet stelen. Het is blijkbaar onmogelijk om het systeem te leren: de troep die je zelf produceert, moet je buiten beschouwing laten.

